Reden ist billig. Zeig mir die Zahlen.
Jede Woche erzählt mir jemand, lokale KI sei die Zukunft. Und jede Woche erzählt mir jemand anderes, das sei Spielzeug und man solle einfach die API bezahlen. Gemessen hat keiner von beiden irgendwas. Das sind Meinungen. Meinungen kosten nichts, und ungefähr so viel sind sie auch wert.
Also, hier sind Zahlen.
Ein Kunde von mir arbeitet mit Daten, die das Haus nicht verlassen sollen. Kundendaten, Verträge, interne Dokumente. Ein Teil davon lief trotzdem über Claude, weil Claude gut ist und das Team ihm vertraut. Schön. Aber eine Cloud-API ist außer Haus. Das ist keine Formalität, das ist die Definition. Und in einem deutschen Unternehmen geht dann sofort der übliche Tanz los: Auftragsverarbeitung, Drittlandtransfer, und was genau mit den Daten passiert, wenn etwas schiefgeht. Diesen Tanz mag niemand.
Der Auftrag: Die lokalen Modelle müssen so gut werden, dass der Wechsel kein Rückschritt ist. Und dann herausfinden, was das wirklich kostet. Nicht schätzen. Messen.
Der Aufbau
Zwei Rechner. Gleicher Tisch, gleiche USV.
Der eine ist eine ganz normale Workstation: Ryzen 9 9950X, 64 GB RAM, RTX PRO 4500 Blackwell mit 32 GB VRAM. Darauf läuft Qwen3.8-27B, dense, 4-Bit-Quant, mit einem kleinen MTP-Kopf für Speculative Decoding. 131k Kontext auf vier Slots. Das sind 29,9 von 32,6 GB. Ja, ein größerer Quant würde reinpassen, wenn ich den Kontext kürze. Nein, das mache ich nicht. Für diese Art Arbeit ist Kontext wichtiger als die letzten paar Prozent Gewichtsqualität, und wer etwas anderes behauptet, hat einem Modell noch keinen echten Vertrag gegeben.
Der andere ist ein DGX Spark mit 128 GB Unified Memory. Darauf läuft Qwen3.8-Flash-Next. Mixture-of-Experts, 125B Parameter, davon etwa 6B aktiv, 3-Bit-Quant.
Beide laufen mit llama.cpp, aus dem Quellcode gebaut, jede Version in ein eigenes Verzeichnis. Warum? Weil ein neuer Build den laufenden Server niemals anfassen darf. Das ist keine Paranoia. So macht man das einfach.
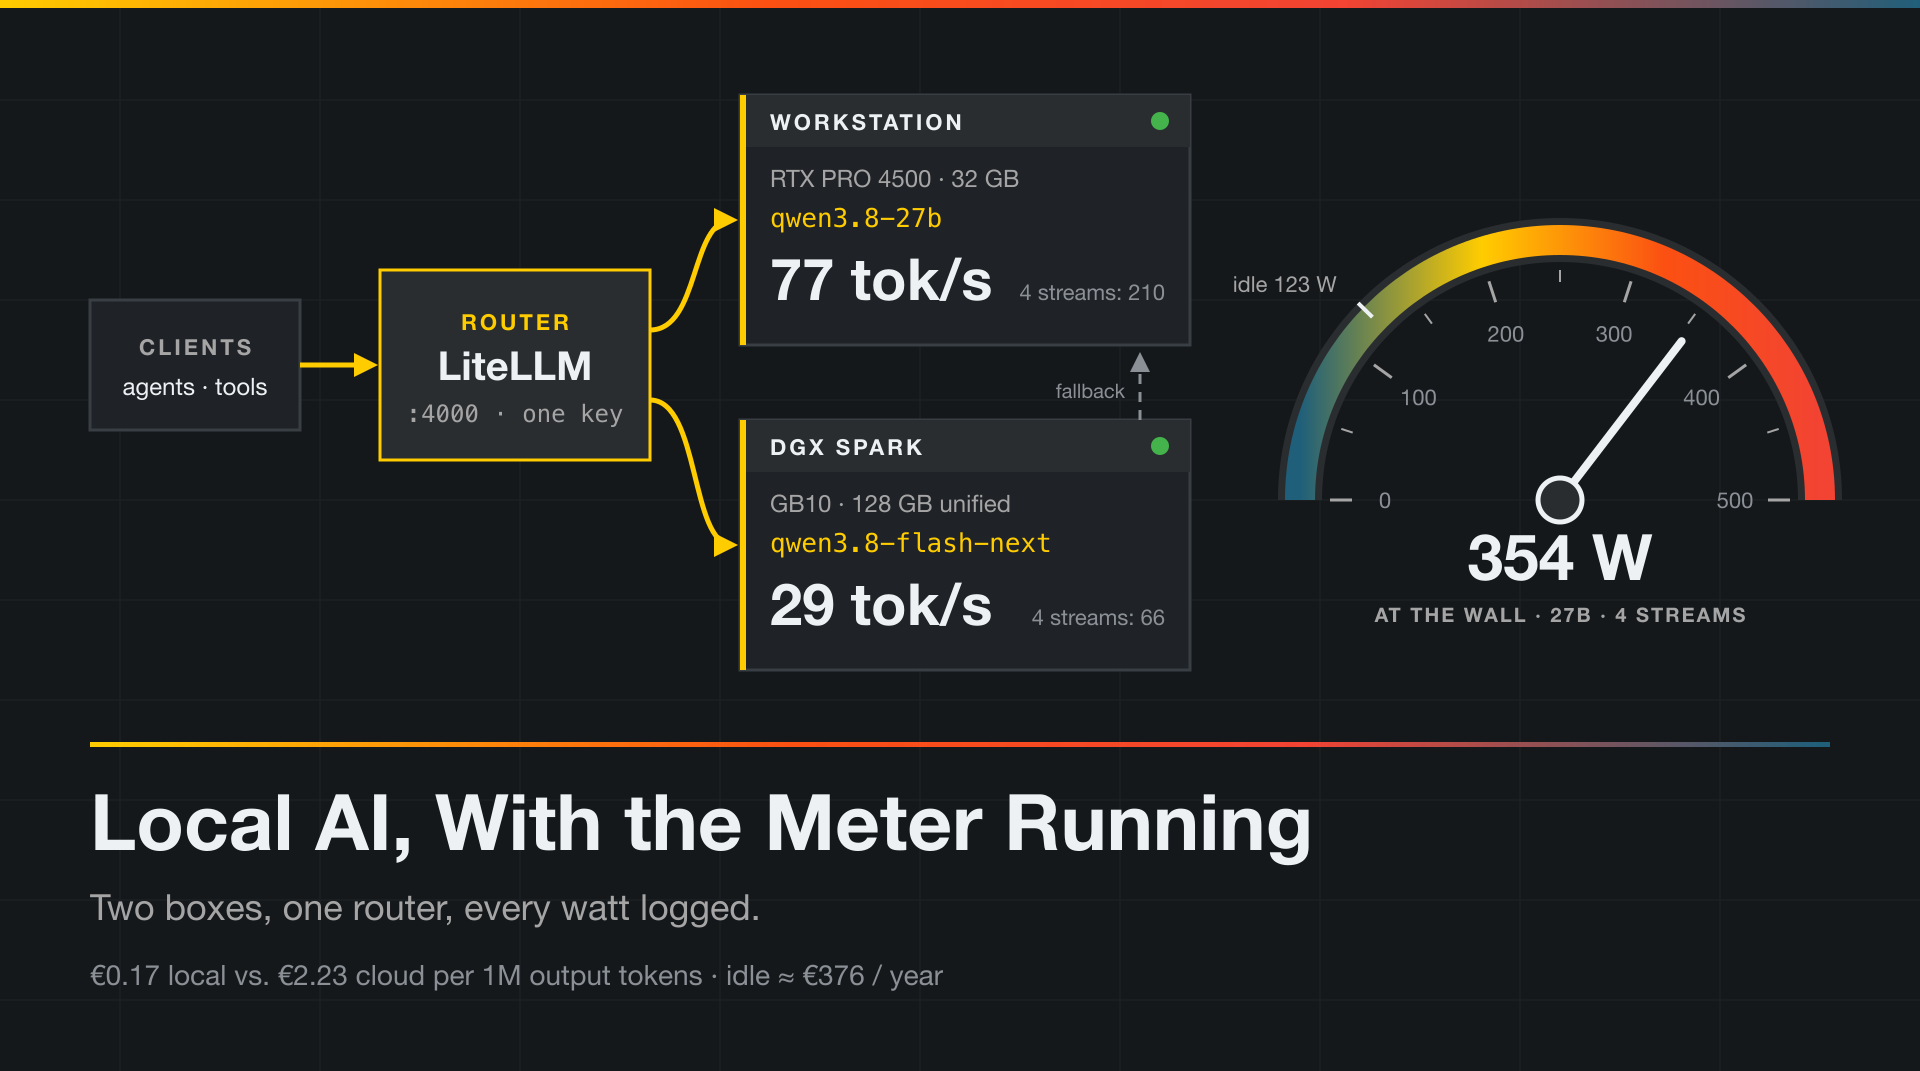
Keiner der beiden Server ist von außen erreichbar. Davor sitzt ein LiteLLM-Router. Ein Schlüssel, ein OpenAI-kompatibler Endpunkt, zwei Modellnamen. Mehr sieht ein Client nie:
client ──► LiteLLM :4000
             ├─ qwen3.8-27b        ──► llama-server (Workstation)
             └─ qwen3.8-flash-next ──► llama-server (Spark)
                                       (Spark weg → Fallback auf das 27B)
Der Fallback ist der wichtige Teil, und genau den lassen alle weg. Spark ausgelastet, startet neu, Netz weg? Dann antwortet das kleine Modell. Die Anfrage schlägt nicht fehl. Der Agent auf der anderen Seite merkt nichts. Das ist der Unterschied zwischen einer Demo und etwas, das Leute tatsächlich benutzen können.
Und weil der Endpunkt die OpenAI-API spricht, heißt Umstellen bestehender Werkzeuge: URL ändern. Fertig. Kein Migrationsprojekt.
Der langweilige Teil IST die Arbeit
Bis ein Modell auf eine curl-Anfrage antwortet: ein Nachmittag. Bis ein Team sich darauf verlassen kann: der Rest der Woche. Und nichts in dieser Woche hatte mit KI zu tun.
Der Treiber. NVIDIAs CUDA-Repository bringt einen Pin mit, der es über Ubuntus eigene Pakete stellt. Und es enthält Treiberbibliotheken. Irgendein zufälliges apt upgrade in drei Monaten ersetzt also fröhlich Ubuntus signierten Treiber durch den von NVIDIA, die Bibliotheken passen nicht mehr zum Kernelmodul, und mit Secure Boot lädt das Modul einfach nicht mehr. Die teure GPU ist jetzt ein Heizlüfter. Die Lösung ist eine Zahl in einer Datei. Teuer ist nur, herauszufinden, dass man sie ändern muss. Das ist immer der teure Teil.
Der Router. LiteLLM braucht seinen Datenbank-Client, auch wenn man gar keine Datenbank benutzt. Ohne ihn kommt jeder Fehler, auch ein völlig normales 401 wegen eines fehlenden Schlüssels, als 500 zurück, das sich über ein fehlendes Python-Modul beschwert. Ein Authentifizierungsfehler, der sich als Import-Fehler ausgibt. Lass dir das mal auf der Zunge zergehen. Fehlermeldungen sind Benutzeroberfläche. Diese hier lügt.
Monitoring. Telegraf auf beiden Rechnern, InfluxDB und Grafana auf dem Spark, Alerts in einen Google-Chat-Space. GPU-Leistung, CPU-Package-Leistung aus dem RAPL-Zähler, VRAM pro Prozess, Tokens pro Sekunde direkt aus llama-server. Und weil das Alerting auf dem Spark läuft, prüft ein kleiner Watchdog auf der Workstation den Spark jede Minute. Sonst wäre ausgerechnet der Ausfall, von dem man am dringendsten erfahren muss, genau der, der es nicht melden kann. Monitoring, das zusammen mit dem überwachten System stirbt, ist kein Monitoring.
Strom. Die USV hängt per USB an der Workstation. NUT liest sie aus und entscheidet selbst, wann der Akku knapp ist: 30 % oder fünf Minuten Restlaufzeit. Dann fährt es zuerst den Spark herunter, wartet auf ihn, und dann sich selbst. Jeder Schritt geht in den Chat, direkt von der Workstation. Nicht von Grafana. Grafana liegt auf dem Rechner, der gerade aus ist.
Das bedeutet „self-hosted“, sobald man über die Demo hinaus ist. Ein Cloud-Modell ist ein Preis pro Token. Ein Modell unterm Schreibtisch ist ein kleines Betriebsproblem, das nebenbei auch Text erzeugt. Wer dieses Problem nicht haben will, soll es lassen. Ernsthaft.
Geschwindigkeit
Eine Stunde Benchmark heute Morgen. Jede Anfrage gestreamt durch den Router, jedes Watt protokolliert.
| Qwen3.8-27B (RTX PRO 4500) | Qwen3.8-Flash-Next (Spark) | |
|---|---|---|
| Generierung, 1 Stream | 77 tok/s | 29 tok/s |
| Generierung, 4 Streams (gesamt) | 210 tok/s | 66 tok/s |
| Prefill, Prompt mit ~28k Tokens | 1.646 tok/s | 659 tok/s |
| Zeit bis zum ersten Token, 28k-Prompt | 17 s | 42 s |
| 10 min Dauerlast, 4 Streams, pro Stream | 53 tok/s | 17 tok/s |
Zwei Dinge.
Vier parallele Streams bringen dem 27B fast den dreifachen Durchsatz von einem. Wenn deine Batch-Jobs und Sub-Agents also in einer Warteschlange stehen, machst du es falsch. Lass sie parallel laufen.
Und beide Modelle gleichzeitig unter Volllast kosten keines von beiden etwas. Der Router ist nicht der Engpass. Die GPUs sind es. So soll das sein.
Das 27B ist also das Arbeitspferd. Sub-Agents, Massenverarbeitung, alles, wo Warten die Kosten sind. Der Spark bekommt die schweren Probleme, bei denen sich das Warten auf eine langsamere Antwort von einem größeren Modell tatsächlich lohnt.
Watt
Die USV meldet ihre Last, also habe ich an der Steckdose gemessen. Beide Rechner, alles drin:
| Zustand | Leistung an der Steckdose |
|---|---|
| Beide im Leerlauf | 123 W |
| 27B generiert, 1 Stream | 352 W |
| 27B generiert, 4 Streams | 354 W |
| Spark generiert, 4 Streams | 232 W |
| Beide generieren, 4 + 4 Streams | 459 W |
Schau dir Zeile zwei und drei an. Die RTX PRO 4500 erreicht ihr Limit von 200 W schon mit einem Stream. Drei Streams mehr: mehr Tokens, gleiche Watt. Batching ist praktisch kostenlos. Wer nicht batcht, verschenkt das.
Geld
Bei 0,35 €/kWh, jedes Watt an der Steckdose gezählt, Leerlauf eingeschlossen. Keine kreative Buchführung. Pro Million Output-Tokens:
| Lokal, 1 Stream | Lokal, 4 Streams | Cloud, Listenpreis | Cloud, günstigster | |
|---|---|---|---|---|
| Qwen3.8-27B | 0,47 € | 0,17 € | 2,23 € | 1,12 € |
| Qwen3.8-Flash-Next | 0,79 € | 0,34 € | 0,42 € | – |
Beim 27B ist der Strom sieben- bis dreizehnmal billiger, als genau dasselbe Modell zu mieten. Solange man es auslastet. Bei Input-Tokens, wo Agents den Großteil ihres Volumens verbrennen, ist es noch einseitiger: etwa zwei Cent pro Million lokal, drei bis 38 Cent in der Cloud.
Jetzt der Spark. Und hier enttäusche ich die Lokale-KI-Fraktion: Das günstigste Cloud-Angebot für Flash-Next kostet ungefähr so viel wie der Strom des Spark. Mit einem einzelnen Stream ist die Cloud sogar billiger. Beim Preis pro Token gewinnt der Spark nicht. Punkt. Er gewinnt, weil die Daten den Raum nie verlassen. Das ist ein völlig legitimer Grund. Man soll nur nicht so tun, als ginge es um den Preis.
Und jetzt die Zeile, die alle in ihren Blogposts praktischerweise weglassen:
Der Leerlauf kostet etwa 376 € im Jahr. Bevor ein einziger Token erzeugt ist. Wer am Tag ein paar Fragen stellt, zahlt im Grunde nur diese Zahl. Läuft das 27B rund um die Uhr unter Volllast, erzeugt es etwa 17,6 Millionen Tokens am Tag und hat ein Jahr Leerlauf in etwa zehn Tagen wieder eingespielt. Die echte Nutzung liegt irgendwo dazwischen. Finde heraus, wo, bevor du Hardware kaufst, nicht danach.
Und nein, die Hardware ist in diesen Zahlen nicht drin. Kaufpreis und Abschreibung entscheiden über den echten Break-even, und das hängt davon ab, was du schon hast und was du sowieso gekauft hättest. Ich werde dir dafür keine Zahl erfinden.
Dafür brauchst du mich aber auch nicht. Preise für GPU und Spark sind eine Suchanfrage entfernt, und einen Taschenrechner hat jeder. Kaufpreis nehmen, auf die Jahre verteilen, die das Ding wirklich läuft, die Leerlaufzeile von oben dazurechnen und neben die aktuelle Cloud-Rechnung legen. Rechne das durch, bevor du Hardware bestellst. Das dauert zehn Minuten.
Der Motor ist nicht das Auto
Autovergleiche sind meistens faul. Aber ich habe lange genug im Automotive-Umfeld gearbeitet, um mir einen zu erlauben.
Das Modell ist der Motor. Das Harness ist alles andere: Lenkung, Räder, Bremsen, Armaturenbrett, Kraftstoffversorgung. Niemand kauft einen Motor. Man kauft ein Auto. Und genau derselbe Motor kommt in einen Sportwagen oder in einen Transporter, und heraus kommen zwei völlig verschiedene Fahrzeuge.
Die meisten „lokale Modelle taugen nichts“-Meinungen, die ich lese, stammen von jemandem, der einen Motor auf eine Palette schraubt und sich dann beschwert, dass sie nicht fährt. Prompt ins Chatfenster, mittelmäßige Antwort, Vergleich mit einem Frontier-Modell, um das ein ganzes Produkt gebaut ist, fertig. Natürlich verliert das. Da wurde ein Motor mit einem Auto verglichen.
Erst das Harness macht aus einem Modell etwas, das Arbeit erledigt. Die Werkzeuge, die es aufrufen kann. Der Kontext, den es bekommt, und der, den es nicht bekommt. Die Anweisungen. Die Dateien, die es lesen kann. Die Prüfungen, die ihm sagen, dass es etwas falsch gemacht hat, und die Schleife, in der es es noch einmal versucht. Und ja, auch die langweilige Infrastruktur von oben: Router, Fallback, Monitoring.
Genau daher kommen unsere Ergebnisse. Nicht von einem größeren Modell. Sondern davon, ein mittelgroßes Modell in ein ordentliches Auto zu setzen. Das 27B allein ist solide. Das 27B im richtigen Harness erledigt echte Arbeit.
Welches Harness? Weniger wichtig, als alle denken. Claude Code, OpenCode, omp, LangChain oder etwas Selbstgebautes für genau eine Aufgabe. Der Router spricht die OpenAI-API und über LiteLLM auch die von Anthropic, also heißt Umstellen auf die lokalen Modelle: eine URL, ein Schlüssel. Entscheidend ist nicht der Name. Entscheidend ist, dass das Harness dem Modell Werkzeuge gibt, den richtigen Kontext und eine Möglichkeit, die eigene Arbeit zu prüfen. Nimm das, was zur Aufgabe passt, nicht das mit den meisten GitHub-Sternen.
Und das heißt auch: Wer ein lokales Modell bewertet, testet das Auto, nicht den Motor. Das ganze Setup, an den eigenen Aufgaben. Alles andere misst das Falsche.
Also, lohnt sich das?
Lokal ergibt Sinn, wenn drei Dinge gleichzeitig zutreffen:
- Deine Daten sind vertraulich. Kundendaten, Verträge, Entwicklungsunterlagen, die das Haus nicht verlassen dürfen. Dann ist die Frage nicht „ist die Cloud billiger“. Die Frage ist „ist die Cloud überhaupt erlaubt“.
- Du hast Volumen. Agents, Batch-Jobs, Dokumente im Hunderterpack. Die Kosten pro Token fallen nur dann so tief, wenn die GPU auch wirklich zu tun hat.
- Jemand kümmert sich um den Betrieb. Treiber, Updates, Monitoring, USV. Nichts davon ist schwer. Alles davon ist Arbeit. Und sie hört nie auf.
Wer einem Chatbot fünf Fragen am Tag stellt, soll es lassen. Das ist eine sehr teure Leerlaufschleife.
Und noch eine ehrliche Ansage: Ein 27B-Modell ist kein Frontier-Modell. Ein gutes Harness schließt einen großen Teil der Lücke. Nicht die ganze. Für viel Alltagsarbeit ist es mehr als gut genug. Für manches nicht. Was davon auf deine Arbeit zutrifft, steht in keinem Datenblatt, und der Hersteller sagt es dir auch nicht. Herausfinden kann man das nur, indem man es an den eigenen Aufgaben testet, mit echten Beispielen und jemandem, der die Ergebnisse tatsächlich beurteilen kann. Alles andere ist Raten.
Schluss
Lokale KI ist nicht kostenlos und keine Magie. Sie ist ein Kasten, der 123 Watt zieht, während er nichts tut, ein Haufen kleiner Betriebsentscheidungen und ein Preis pro Token, der die Cloud um eine Größenordnung schlägt, wenn man sie auslastet, und gegen sie verliert, wenn nicht.
Was man dafür bekommt, ist Kontrolle. Die Daten bleiben, wo sie sind. Das Modell ist das, das man gemessen hat, nicht das, was der Anbieter diese Woche ausliefert. Und wenn es kaputtgeht, sieht man die Anfrage, die Antwort und die Watt. Und man kann es reparieren.
Das war der Auftrag. Der Zähler sagt, er hält.